Claude Sonnet 5.5 explicado desde cero
Claude Sonnet 5.5, el modelo de Anthropic para el día a día, acaba de recibir una mejora grande. Aquí va qué cambió y el único punto donde el consejo de la semana pasada tiene una excepción.
Qué es Sonnet 5.5, sin tecnicismos
Anthropic lanzó Claude Sonnet 5.5 el 28 de septiembre de 2026, seis días después de Opus 5.5. Los dos son modelos, que es simplemente el nombre de la IA que te contesta dentro de la app de Claude.
Imagínate dos cocineros en la misma cocina. A Sonnet, Anthropic le deja las tareas del día a día, las que están bien delimitadas. A Opus le toca el trabajo difícil y abierto, y según Anthropic ahí sigue siendo claramente mejor.
Lo que mejoró, según Anthropic:
- Lee gráficas muchísimo mejor que Sonnet 5.
- En trabajo de oficina, como hojas de cálculo y presentaciones, queda casi empatado con Opus 5.5.
- Escribe sus respuestas 30% más rápido o más.
- Lo que ya funcionaba con Sonnet 5 debería seguir funcionando.
Ese último punto es el que más te importa. Todos los hábitos del post de Opus 5.5 aplican aquí, con una excepción que te explico más abajo.
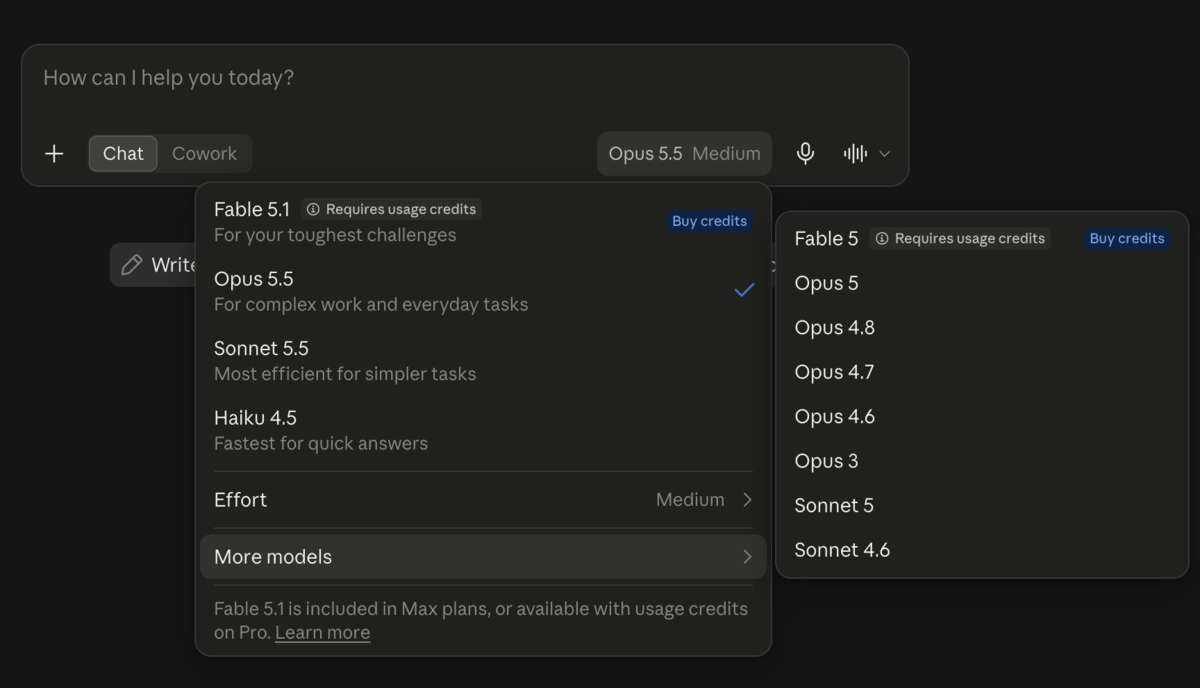
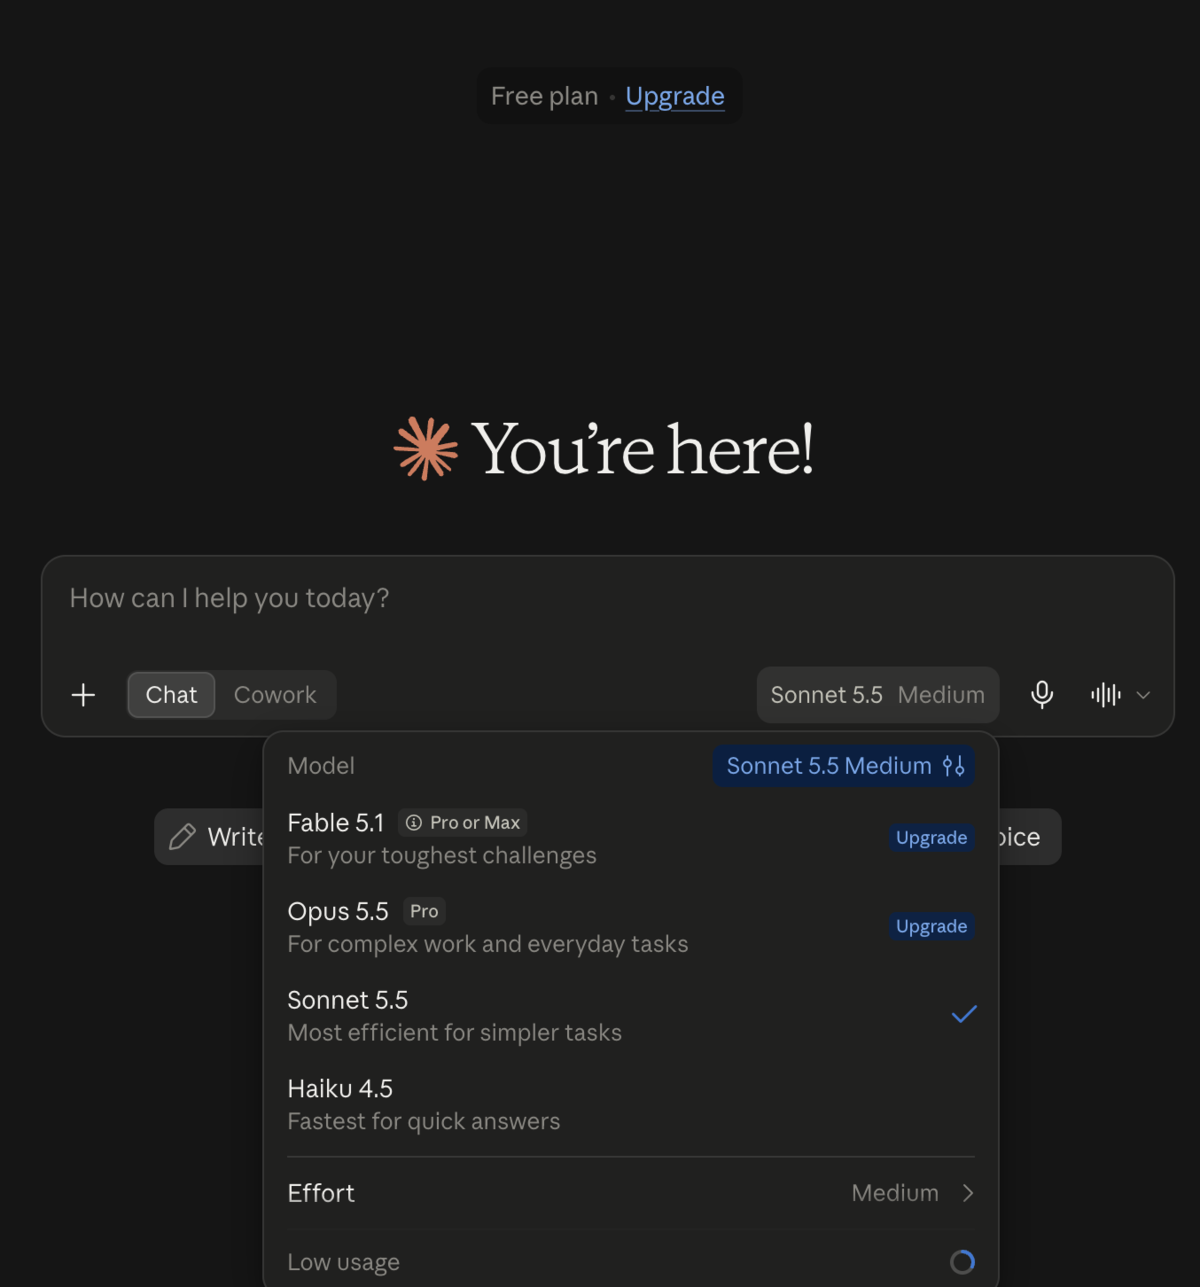
El ajuste de Effort (esfuerzo) funciona igual que la semana pasada: controla cuánto piensa el modelo antes de contestar. Anthropic dice que sus apps arrancan a Sonnet 5.5 en Medium, y eso mismo vi en mis dos cuentas. Déjalo ahí para casi todo.
Buena noticia si no pagas: las cuentas gratis ya tienen Sonnet 5.5. Revisé el menú de modelos en una cuenta gratis el 28 de septiembre y ahí estaba. Además, las cuentas gratis ahora traen el mismo menú de Effort, donde la semana pasada había una barra entre Budget e Intelligence. Todos los consejos de abajo funcionan en el plan gratis.
Cómo hablarle
La versión corta: háblale como le hablabas a Opus 5.5. La tabla junta los puntos donde Sonnet 5.5 se porta distinto, más dos hábitos que vale la pena repetir.
| Cuando quieres | Haz esto |
|---|---|
| Una respuesta rápida | Pídelo y ya. Deja el Effort en Medium |
| Totales, reglas o rankings sacados de un documento | Agrega “Resuélvelo con calma antes de contestar”, o súbele un nivel al Effort |
| Que piense menos o conteste más rápido | Bájale al Effort. Pedírselo con palabras no siempre funciona |
| Solo ideas | Dile “Solo dame ideas. Todavía no hagas nada.” |
| Precios, reglas o cuotas que pudieron cambiar | Agrega “Búscalo en la web para confirmar, aunque creas que ya lo sabes.” |
| Ayuda con una gráfica muy cargada | Recorta la captura a la parte que te interesa |
| El Effort al máximo “por si acaso” | No. Medium es el punto de partida correcto |
Fuentes: la guía “Prompting Claude Sonnet 5.5” de Anthropic y su anuncio de Sonnet 5.5 (los dos en inglés). Casi todas las filas adaptan consejos que Anthropic escribió para desarrolladores. Lo de recortar la gráfica es sugerencia mía.
La segunda fila merece una explicación, porque parece que contradice la regla de la semana pasada. No la contradice. Te dije que dejaras de escribir “piensa paso a paso”, y eso sigue en pie para casi todo. Esa regla hablaba de frases mágicas que la gente le pega a cualquier petición.
Esta línea tiene un trabajo muy concreto: números o reglas que salen de un documento. La guía de Anthropic dice que en tareas como sumar cifras o aplicar una regla, Sonnet 5.5 “muchas veces contesta sin pensar primero, sobre todo con esfuerzo bajo o medio”. Y Medium es justo donde arranca la app.
La línea que trae la guía es “Think the problem through before you answer.” La mía es una adaptación, escrita a propósito para que no suene a la frase que acabas de soltar. Anthropic dio ese consejo pensando en desarrolladores, así que tómalo como algo que puede ayudar, y revisa mi prueba más abajo. ¿Te da flojera escribirla? Súbele un nivel al Effort, lo mismo que el post pasado sugería para tareas difíciles.
La fila de las ideas sale de una advertencia de la misma guía: si le pides algo muy abierto, puede ponerse a “armar una presentación” cuando tú solo querías ideas. Una oración al principio lo evita.
Prompts para probar
Yo utilicé lo que está entre corchetes como ejemplo. Usa números inventados y gráficas públicas (una gráfica del INEGI o de cualquier oficina de estadística funciona muy bien), nunca nada del trabajo, y tapa cualquier dato personal antes de compartir una captura.
Aquí va una captura de una gráfica. En dos oraciones, ¿qué dice y qué llama la atención?
Aquí está mi lista de gastos. Súmalos por categoría. Resuélvelo con calma antes de contestar.
Dame 5 ideas para [algo]. Solo ideas, todavía no hagas nada.
Haz una hoja de presupuesto sencilla de una página con estos números: [números inventados].
¿Cuánto cuesta ahora [trámite o cuota pública]? Búscalo en la web para confirmar, aunque creas que ya lo sabes.
Lo que pasó cuando los probé
Empecé con el prompt de la gráfica y un mapa público de Our World in Data: el porcentaje de la población de cada país que usó internet en 2022 (datos de la UIT, licencia CC BY).
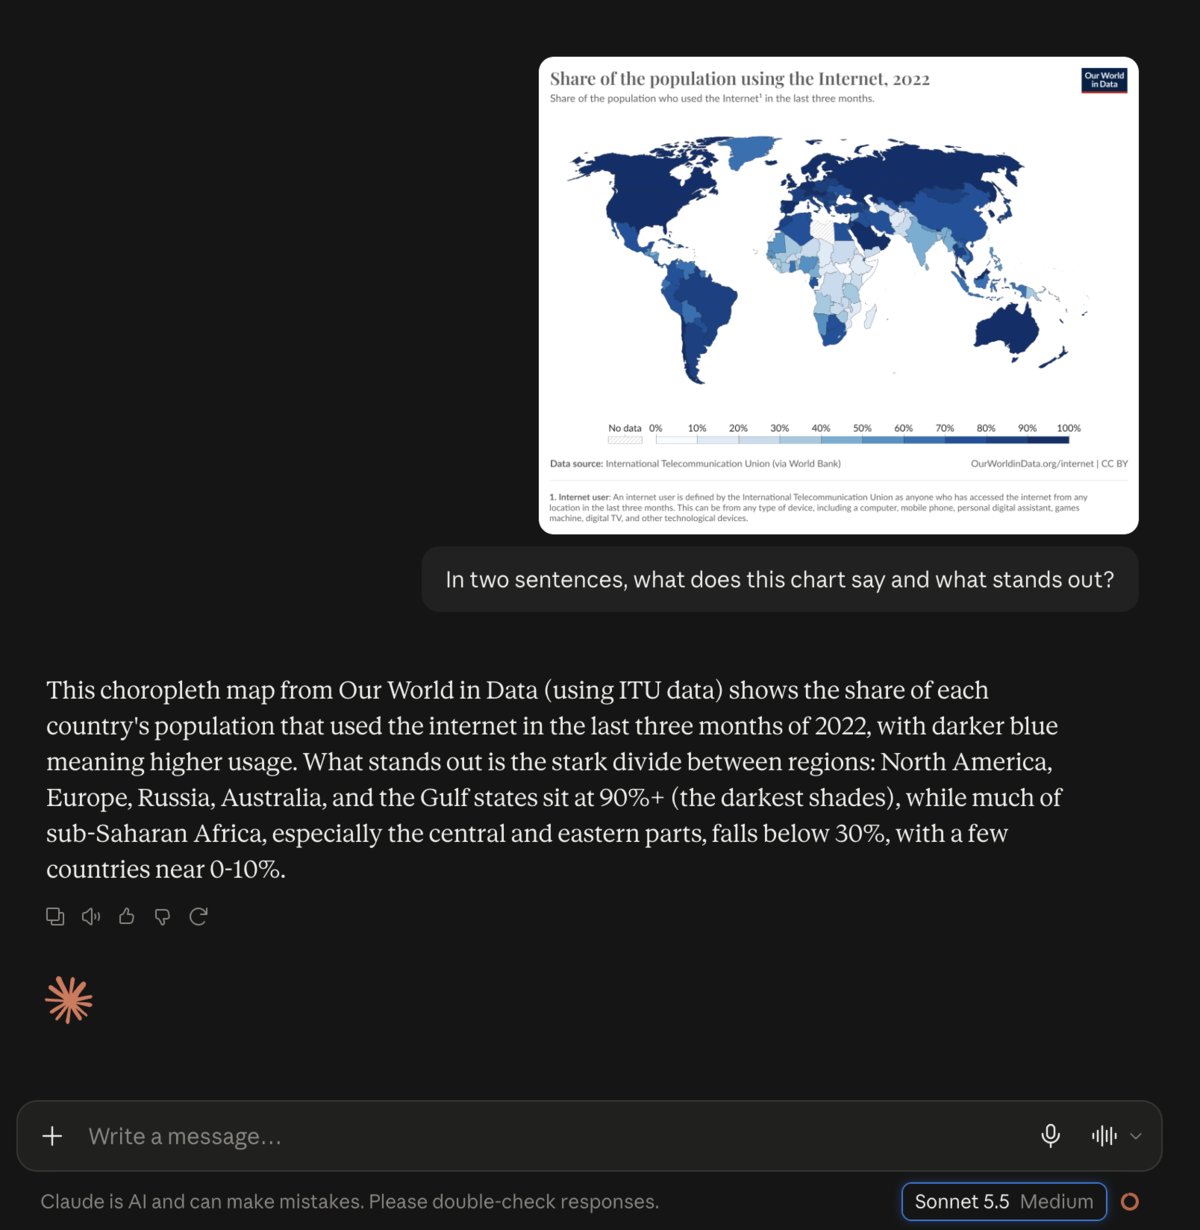
Dijo de dónde venían los datos, explicó que el azul más oscuro significa más gente conectada y se fue directo a lo importante: casi todas las regiones ricas pasan del 90%, mientras gran parte del África subsahariana queda por debajo del 30%. Eso coincide con los colores del mapa. Y lo dijo en dos oraciones, como le pedí.
Luego la prueba que sostiene la excepción de este post. Inventé una lista de gastos con dos trampas: una cena sin monto, solo “mi parte de $84.60 dividido entre 3”, y un reembolso que hay que restar. Se lo pedí sin más, en Medium y sin la línea extra. La prueba la hice en inglés, por eso la captura sale así.
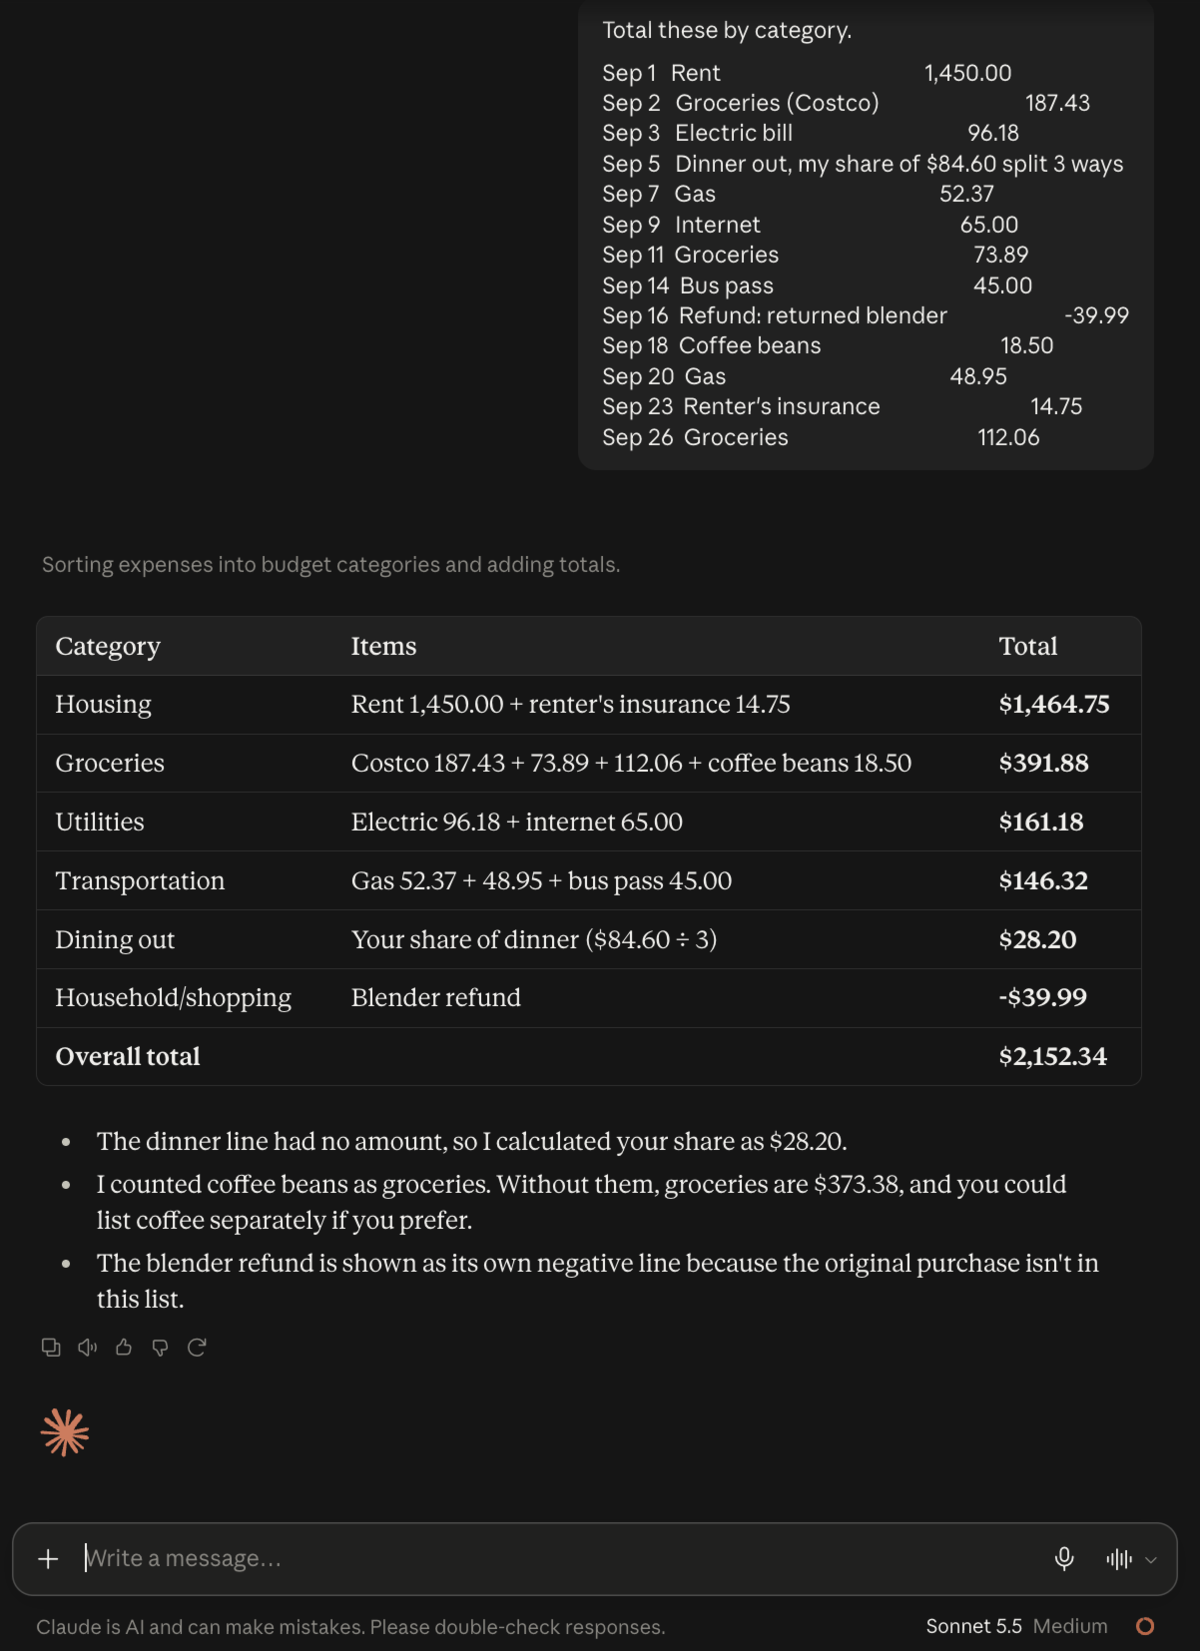
Le atinó a todo. Calculó mi parte de la cena en $28.20 y restó el reembolso, y su total de $2,152.34 coincide con el mío al centavo. O sea que con una lista de este tamaño la línea extra no hizo falta. La dejo en la tabla como un seguro barato para documentos más largos y revueltos, no como algo obligatorio.
Al final, la advertencia de las ideas. Le pedí cinco ideas para una salida de equipo y le agregué que solo quería ideas y que todavía no armara nada (lo pedí en inglés).
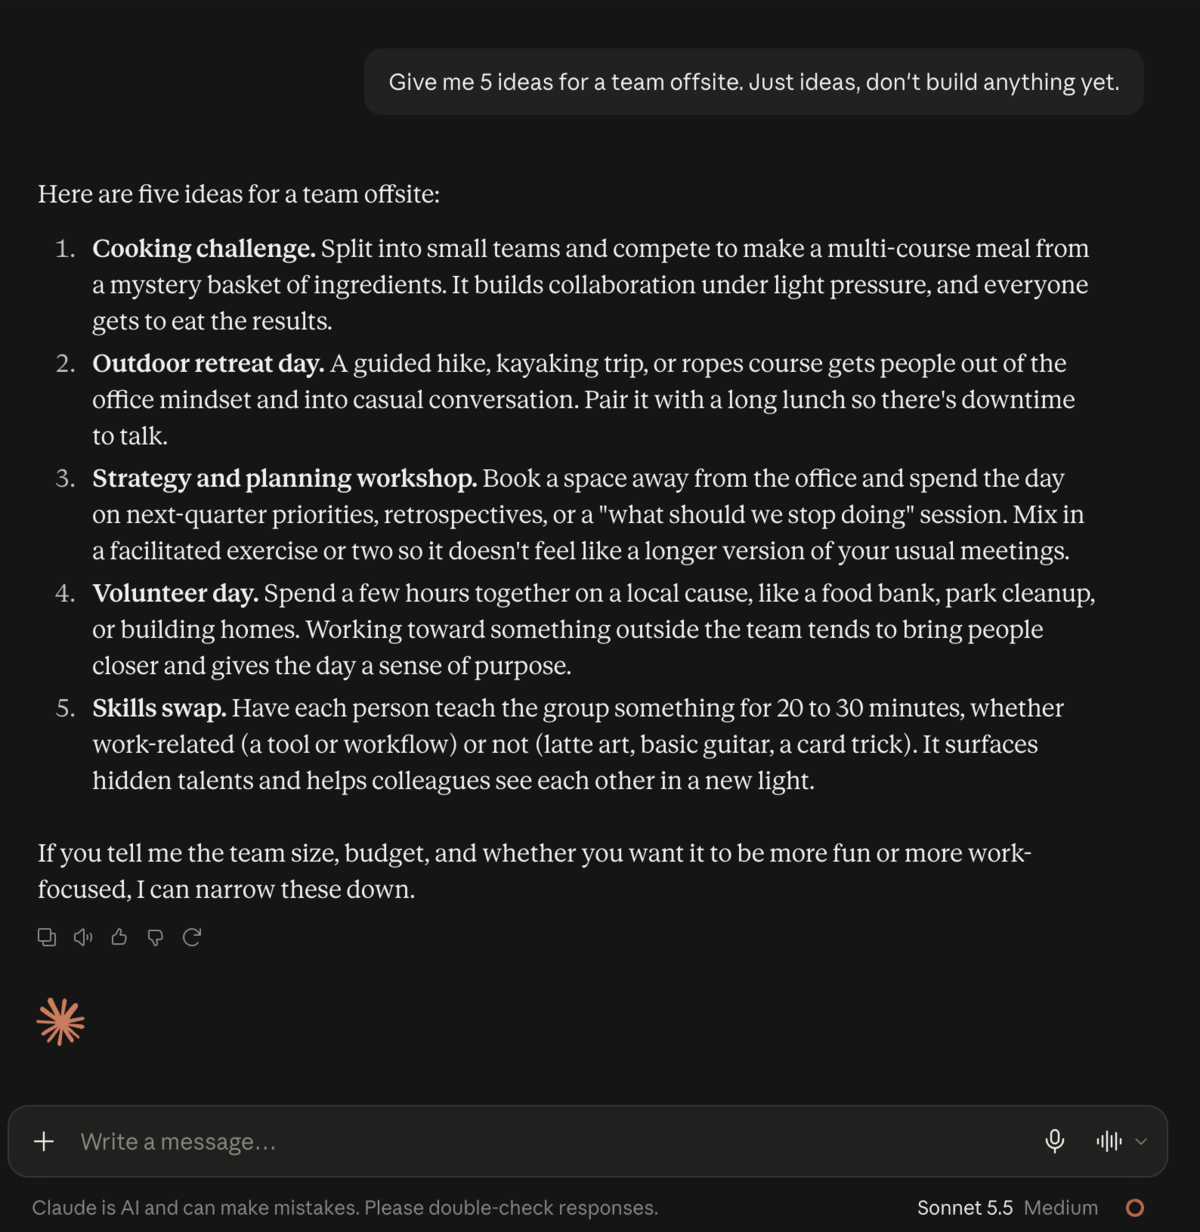
Cinco ideas cortas y luego una pregunta sobre el tamaño del equipo y el presupuesto antes de seguir. Justo lo que quieres. No probé la versión abierta, así que lo de “se puede poner a armar algo” es advertencia de Anthropic, no algo que yo haya visto.
Para los curiosos: lo viejo contra lo nuevo
Aquí vienen números. La versión corta: Sonnet 5.5 cuesta la mitad por token que Opus 5.5 y queda muy cerca de él en varias pruebas de Anthropic. Aun así, Anthropic dice que Opus sigue siendo claramente más fuerte en trabajo difícil y abierto.
Mini glosario. Un benchmark es una prueba estándar para comparar modelos de IA. Reportado por el fabricante significa que Anthropic probó su propio modelo. Un token es un pedacito de texto, más o menos una palabra corta. El esfuerzo (Effort) es cuánto piensa el modelo antes de contestar, el mismo ajuste que viste en el menú de la app. Con herramientas significa que el modelo pudo usar ayudas, como correr código, durante la prueba. Sin herramientas, que no pudo.
| Sonnet 5.5 (nuevo) | Sonnet 5 | Opus 5.5 | Opus 5 | Haiku 4.5 | |
|---|---|---|---|---|---|
| Lanzamiento | 28 sep 2026 | 30 jun 2026 | 22 sep 2026 | 24 jul 2026 | oct 2025 |
| Precio para desarrolladores, USD por millón de tokens (entrada / salida)** | $2 / $10 | $2 / $10 | $4 / $20 | $5 / $25 | $1 / $5 |
| Conocimiento hasta | jun 2026 | ene 2026 | jun 2026 | may 2026 | feb 2025 |
| Esfuerzo predeterminado para desarrolladores | alto | alto | medio | alto | n/a |
| Esfuerzo en la app | Medium (según Anthropic) | Medium (mi captura, 27 sep) | Medium (mi captura) | sin verificar | n/a |
| Velocidad | 30%+ más rápido al escribir que Sonnet 5 | rápido | 30%+ más rápido al escribir que Opus 5 | referencia | el más rápido |
| Planes en la app de Claude | Gratis en adelante | Planes de pago, en More models (era el de Gratis hasta el 27 sep) | Pro en adelante, no en Gratis | Pro y Max (al lanzarse) | Gratis en adelante |
| Terminal-Bench 4.0, tareas de programación | 70.6% | 10.3% | 66.4%* | 52.3% | n/p |
| GDPval-AA v2.1, trabajo de oficina (puntaje Elo) | 1844 | 1449 | 1846 | 1708 | n/p |
| OSWorld 2.1, uso de una computadora | 80.1% | 57.0% | 81.8% | 74.0% | n/p |
| Chartography, lectura de gráficas sin herramientas | 61.6% | 15.6% | 64.4% | solo hay dato con herramientas | n/p |
| Índice de Artificial Analysis, esfuerzo más alto (independiente) | 56 | 38 | 58 | sin dato | n/p |
**Estos son los precios anunciados en el lanzamiento, no prometo mantenerlos actualizados.
Las filas de benchmarks son reportadas por Anthropic, salvo la marcada como independiente. n/p significa que no se publicó en la comparación de ese modelo. Los puntajes de Opus 5 vienen del anuncio de Opus 5.5 de Anthropic. “Al lanzarse” describe los planes cuando salió ese modelo, y pudieron cambiar desde entonces.
*El puntaje de Opus 5.5 en Terminal-Bench se midió con su esfuerzo más alto, que según Anthropic representa el mejor resultado del modelo.
Ojo con la fila de gráficas. El post de la semana pasada mostraba puntajes con herramientas, donde Opus 5.5 llegó a 89.0%. Los de esta tabla son sin herramientas, una prueba más difícil. No compares números entre los dos posts.
El esfuerzo merece la misma advertencia que la semana pasada, pero más fuerte. Artificial Analysis, un evaluador independiente, probó Sonnet 5.5 en cada nivel de esfuerzo:
| Esfuerzo | Puntaje del índice | Costo por tarea de prueba |
|---|---|---|
| bajo | 36 | $0.41 |
| medio | 41 | $0.59 |
| alto | 47 | $1.08 |
| xhigh | 52 | $2.74 |
| máximo | 56 | $7.60 |
Fíjate en el brinco del final. En máximo, cada tarea costó más que los $5.98 de Opus 5.5 en su propio máximo. El modelo barato deja de ser barato en cuanto le subes todo. Son precios para desarrolladores, en dólares. Mi suposición, no un dato medido: en un plan de pago, pensar de más probablemente también se come tus límites de uso más rápido.
Anthropic dice lo mismo desde el otro lado. Según su anuncio, en Medium Sonnet 5.5 supera el mejor puntaje de Sonnet 5 en Terminal-Bench 4.0 por menos de una décima parte del costo por tarea, y en la mayoría del trabajo cuesta hasta 30% menos por tarea que Sonnet 5.
Dos notas más chicas. Haiku 5.5, el modelo más ligero de la familia, llega “en las próximas semanas”, según el anuncio. Y Anthropic dice que Sonnet 5.5 es el primer Sonnet que le gana a Pokémon Red usando solo capturas de pantalla, que es una forma divertida de decir que ahora ve mejor.
Fuentes (en inglés): anuncio de Sonnet 5.5 de Anthropic, Prompting Claude Sonnet 5.5, anuncio de Opus 5.5 de Anthropic, precios de Claude y los costos por nivel de esfuerzo de Artificial Analysis.
Para arrancar no necesitas ninguno de estos números. Agarra esa gráfica que nunca terminas de entender, súbela y pregúntale qué dice.